این اولین پست از سری یادگیری AI منه. تصمیم گرفتم از دوره Elements of AI شروع کنم، چون به جای این که مستقیم بره سراغ مدل و کد، اول چند تا سوال ساده ولی مهم می پرسه.
مثلا وقتی می گیم AI، دقیقا منظورمون چیه؟ یک چت بات؟ ماشین خودران؟ پیشنهادهای اینستاگرام؟ یا رباتی که یک روز صبح بیدار می شه و می گه قهوه تلخ می خواد؟
برای من، جواب این سوال مهمه چون خیلی راحت می شه هر چیزی که کمی عجیب یا جدید به نظر می رسه را AI صدا زد. بعد هم انتظارهایی ازش ساخت که هیچ ربطی به کاری که واقعا انجام می ده ندارن.
جلسه اول این دوره، بیشتر از این که بخواد جواب قطعی بده، کمک می کنه سوال ها را بهتر ببینم. به نظرم شروع خوبی برای کسیه که می خواد AI را بدون دود و نور آبی اضافی بشناسه.
چرا این سری را شروع کردم
AI این روزها همه جا هست. از پیشنهاد فیلم و موسیقی گرفته تا ابزارهای تولید متن و تصویر. من هم مثل خیلی ها اول از سمت ابزارها واردش شدم. یک ابزار کار جالبی انجام می ده، آدم چند دقیقه ذوق می کنه، بعد می پرسه پشت صحنه چه خبره؟
برداشت من اینه که یاد گرفتن AI فقط حفظ کردن اسم مدل ها نیست. اگر نفهمم یک سیستم دقیقا چه کاری بلده، با چه داده ای کار می کنه و کجا ممکنه اشتباه کنه، خیلی زود اسیر اسم های قشنگ می شم.
این فرق فقط بازی با کلمه ها نیست. فرض کن یک شرکت می گه ابزارش با AI استخدام را بهتر می کنه. قبل از این که از اسمش هیجان زده بشم، باید بدونم خروجی ابزار چیه، چه کسی بر اساس آن تصمیم می گیره، داده اش از کجا اومده و اگر اشتباه کرد چه کسی جوابگوئه. همین سوال ها برای یک پیشنهاددهنده فیلم هم مفیدن، فقط معمولا آسیب اشتباه پیشنهاد فیلم با اشتباه در استخدام یکی نیست.
تعریف های کاری جدید هم کمک می کنن بحث را زمینی نگه دارم. مثلا NIST یک سیستم AI را سامانه ای ماشین محور می دونه که برای هدف های مشخص، خروجی هایی مثل پیش بینی، پیشنهاد یا تصمیم تولید می کنه و روی محیط واقعی یا مجازی اثر می ذاره. تعریف OECD هم روی این تاکید داره که سیستم از ورودی ها نتیجه می گیره و درجه خودمختاری و سازگاری اش می تونه فرق کنه. این ها قرار نیست آخرین جواب فلسفی باشن. فقط یک راه خوب برای توصیف سیستمی هستن که واقعا داریم درباره اش حرف می زنیم.
شروع این مسیر با سوال «AI چیست؟» شاید خیلی ابتدایی به نظر بیاد، ولی دقیقا همان سوالیه که جواب نصف بحث های شلوغ اینترنت را مرتب می کنه.
اول این سوال را درست بپرسیم
دوره Elements of AI از همان اول یادآوری می کنه که برای AI یک تعریف رسمی و مورد توافق همه وجود نداره. حوزه ای که مدام رشد می کنه و ابزارهای تازه می سازه، مرزش هم ثابت نمی مونه.
خود اسم AI هم تاریخ جالبی داره. اصطلاحش در پیشنهاد پروژه تابستانی Dartmouth در سال ۱۹۵۵ به کار رفت و آن پروژه در تابستان ۱۹۵۶ برگزار شد. جان مک کارتی، ماروین مینسکی، کلاد شنون و ناتانیل راچستر در آن پیشنهاد خوش بینانه فرض کرده بودن بخش های مختلف یادگیری و هوش را می شه آن قدر دقیق توصیف کرد که ماشین بتوانه شبیه سازیشون کنه. این وعده هنوز هم بزرگه و همین بزرگی یکی از دلیل های اختلاف بر سر تعریف AI شده.
یک تعریف ممکنه دنبال رفتار انسان مانند باشه. یک تعریف دیگر روی حل مسئله، تصمیم گیری یا رسیدن به هدف تمرکز کنه. تعریف های فنی تر هم بیشتر به ورودی، مدل، خروجی و اثر سیستم نگاه می کنن. هیچ کدوم به تنهایی همه چیز را پوشش نمی دن. برای مثال، یک برنامه شطرنج می تونه در شطرنج خیلی قوی باشه ولی درک تصویری یا مهارت اجتماعی نداشته باشه. پس «هوش» را نمی شه مثل دمای هوا با یک عدد ساده سنجید و گفت این یکی از آن یکی باهوش تره.
یک شوخی قدیمی می گه AI یعنی کارهای خفنی که کامپیوتر هنوز نمی تونه انجام بده. به نظرم شوخی خوبیه، چون یک ایراد واقعی را نشان می ده. وقتی کامپیوتر آن کار را یاد گرفت، خیلی وقت ها دیگر عادی می شه و از چشم ما می افته.
مثلا جستجو، مسیریابی یا بازی شطرنج زمانی خیلی نزدیک به AI به نظر می رسیدن. امروز بخشی از این کارها آن قدر عادی شدن که شاید اصلا موقع استفاده بهشان فکر نکنیم. این به معنی ساده بودنشان نیست، فقط بهشان عادت کردیم.
پس من AI را یک وسیله جادویی یا یک موجود مستقل نمی بینم. AI یک حوزه از علوم کامپیوتره که مجموعه ای از مسئله ها و روش ها را در خودش داره. بهتره به جای این که بگم «یک AI این کار را کرد»، بگم «یک سیستم یا روش AI این کار را انجام داد».
این تفکیک بین «حوزه» و «سیستم» برای من کاربردیه. مثل اینه که نگم «یک ریاضی مسئله را حل کرد». می گم یک برنامه یا یک مدل با استفاده از روش های ریاضی مسئله را حل کرد. AI هم یک جعبه ابزار بزرگه. مدل زبانی، سیستم بینایی ماشین، موتور جستجو و بازوی رباتیک هر کدوم یکی از ابزارها یا محصول های این حوزه ان، نه خود کل حوزه.
سه مثال که تصویر را واقعی می کنن
اولین مثال دوره، ماشین خودرانه. یک ماشین خودران فقط قرار نیست فرمان را بچرخونه. باید مسیر پیدا کنه، عابر و ماشین های اطراف را تشخیص بده، وضعیت نامطمئن را مدیریت کنه و برای حرکت بعدی تصمیم بگیره.
برای این کار چند مسئله جدا باید همزمان کنار هم کار کنن. بینایی ماشین باید نشانه های محیط را از دوربین یا حسگرها بگیره. مسیریابی باید راه مناسب را پیدا کنه. برنامه ریزی باید تصمیم بگیره در چند ثانیه بعد چه حرکتی امن تره. تازه دنیای واقعی هم تمیز و ثابت نیست. باران، نور بد، دوچرخه سواری که ناگهانی تغییر مسیر می ده یا تابلویی که بخشی ازش پوشیده شده، همه وارد قصه می شن. برای همین یک دمو خوب در خیابان خلوت، به تنهایی مدرک آماده بودن سیستم برای هر خیابون نیست.
مثال دوم، پیشنهاد محتواست. وقتی یک سرویس فیلم، موسیقی یا شبکه اجتماعی چیزهایی را جلویم می ذاره که احتمالا دوست دارم، دارد از اطلاعات قبلی من و الگوهای رفتاری آدم های مشابه استفاده می کنه. این پیشنهادها گاهی واقعا مفید هستن. گاهی هم باعث می شن آدم سه ساعت ویدیو ببینه و آخرش ندونه چطور به ویدیوی تعمیر سماور رسیده.
نکته مهم اینه که این سیستم ها فقط سرگرمی را تغییر نمی دن. چیزی که می بینیم، خبرهایی که جلویمون میان و بحث هایی که بهشان می رسیم هم می تونن شخصی سازی بشن. برای همین حرف زدن از حباب فیلتر و اتاق پژواک فقط یک بحث تئوری نیست.
اینجا یک حلقه بازخورد هم می تونه شکل بگیره. پیشنهاد سیستم روی چیزی که من می بینم اثر می ذاره، واکنش من دوباره به داده سیستم برمی گرده و پیشنهاد بعدی را تغییر می ده. واژه نامه یادگیری ماشین گوگل همین الگو را برای سامانه های پیشنهاددهنده مثال می زنه. پس وقتی فقط نرخ کلیک را معیار موفقیت بگیرم، ممکنه سیستم در گرفتن کلیک خوب باشه ولی در نشان دادن محتوای متنوع یا مفید خوب نباشه. معیار انتخابی، رفتار سیستم را شکل می ده.
سومین مثال، پردازش تصویر و ویدیوه. تشخیص چهره، پیدا کردن عابر برای ماشین، دسته بندی عکس ها و تولید یا تغییر تصویر، همگی از نمونه های مهم این بخش هستن. هر چه ساختن تصویر و ویدیوی واقع گرایانه راحت تر می شه، اعتماد کردن صرف به چیزی که می بینیم هم سخت تر می شه. جمله «دیدم، پس واقعی بود» دیگر آن قدرها محکم نیست.
این بخش برای من یک یادآوری ساده هم داره: کیفیت ظاهری با حقیقت یکی نیست. یک تصویر می تونه واقعی باشه ولی خارج از زمینه درست استفاده بشه. یک تصویر ساختگی هم ممکنه خیلی تمیز و قانع کننده به نظر بیاد. برای محتواهای مهم، منبع، زمان، زمینه و راه های تایید مستقل مهم تر از اینن که تصویر چقدر طبیعی به نظر می رسه.
خودمختاری و سازگاری، دو سرنخ خوب
دوره برای نزدیک شدن به یک تعریف کاربردی تر، روی دو ویژگی دست می ذاره: خودمختاری و سازگاری.
خودمختاری یعنی یک سیستم بتونه در یک محیط پیچیده، بدون این که کاربر لحظه به لحظه هدایتش کنه، کاری را جلو ببره. یک ربات جاروبرقی که مسیر را تشخیص می ده و به دیوار نمی کوبه، از یک برنامه ساده که فقط با زدن دکمه روشن می شه، خودمختارتره.
سازگاری یعنی سیستم بتونه با تجربه یا داده بیشتر، عملکردش را بهتر کنه. اینجا معمولا پای یادگیری ماشین وسط میاد. مثلا اگر یک مدل با دیدن نمونه های بیشتر، در تشخیص ایمیل اسپم بهتر عمل کنه، دارد سازگار می شه.
این دو ویژگی هم همه چیز را حل نمی کنن. یک سیستم ممکنه خودمختار باشه ولی یاد نگیره. یک مدل هم ممکنه از داده یاد بگیره، ولی بدون دخالت آدم هیچ کاری را شروع نکنه. با این حال برای من مثل دو چراغ کوچیک هستن که کمک می کنن هر ابزار جدیدی را بهتر بررسی کنم.
یک تفاوت مهم اینجا بین زمان آموزش و زمان استفاده است. خیلی از مدل ها اول با یک مجموعه داده آموزش می بینن و بعد در محصول فقط روی ورودی تازه خروجی می دن. یعنی هر بار که من از مدل استفاده می کنم، لزوما همان لحظه در حال یاد گرفتن از من نیست. به روز شدن مدل، جمع کردن داده تازه، بررسی کیفیت و آموزش دوباره معمولا یک فرایند جداست. پس دیدن خروجی متغیر از یک مدل، به تنهایی یعنی سازگاری زنده و لحظه ای نیست.
اتوماسیون و AI هم هم معنی نیستن. یک برنامه که هر روز ساعت هشت گزارش را ایمیل می کنه، اتوماسیون مفیدیه ولی لازم نیست یادگیری داشته باشه. از آن طرف، یک سامانه AI می تونه در دل یک فرایند کاملا خودکار قرار بگیره. مرز دقیق به تعریفی که انتخاب می کنم بستگی داره و بعضی تعریف های گسترده حتی سیستم های قانون محور را هم کنار روش های یادگیرنده می ذارن. نکته عملی برای من اینه که بپرسم کدام بخش واقعا از داده الگو گرفته و کدام بخش فقط دستور مشخص اجرا می کنه.
برای هر محصول AI، سه سوال دارم:
- دقیقا چه کار مشخصی را انجام می ده؟
- کجا بدون هدایت آدم تصمیم می گیره؟
- آیا با داده یا بازخورد بیشتر بهتر می شه، یا فقط یک قانون از قبل نوشته شده را اجرا می کنه؟
کلمه هایی که زیادی بار دارن
بعضی کلمه ها خیلی بیشتر از چیزی که فکر می کنیم بار دارن. «فهمیدن»، «یاد گرفتن» و «باهوش بودن» از همین جنس هستن. وقتی می گیم یک مدل تصویر را می فهمه، ممکنه ناخودآگاه تصور کنیم مثل آدم از معنای تصویر خبر داره.
اما یک سیستم بینایی ماشین ممکنه ماشین، آدم و خیابون را در تصویر تشخیص بده، بدون این که جهان را مثل ما تجربه کنه. توانایی انجام یک کار مشخص، لزوما به معنی داشتن درک عمومی از همه چیز نیست.
ماروین مینسکی برای این مدل واژه ها اصطلاح «کلمه چمدانی» را به کار برده بود. یعنی یک کلمه که انگار یک عالمه معنی را با خودش حمل می کنه. وقتی می گیم چیزی باهوشه، ممکنه توانایی حل مسئله، آگاهی، خلاقیت، زبان و چند چیز دیگر را یکجا به آن نسبت بدیم.
به نظرم خوبه هر وقت شنیدم یک سیستم «می فهمه» یا «باهوشه»، یک سوال اضافه بپرسم: دقیقا چه کاری را انجام می ده؟ جواب همین سوال معمولا خیلی مفیدتر از برچسب باهوش یا غیر باهوشه.
این سوال در عمل به بحث ارزیابی می رسه. اگر یک مدل در پاسخ به چند مثال آشنا خوب جواب بده، هنوز نمی دونم با مثال جدید، لهجه متفاوت، نور بد، داده ناقص یا درخواست مبهم چه کار می کنه. یک سیستم خوب فقط با جواب های قشنگ شناخته نمی شه. باید ببینم روی چه داده ای آزمایش شده، خطایش چه شکلیه و آن خطا در موقعیت واقعی چقدر هزینه داره.
برای نمونه، یک فیلتر اسپم اگر چند ایمیل سالم را اشتباه کنار بزنه، آزاردهنده هست. ولی اگر یک سیستم تشخیص پزشکی یا استخدام همان نوع اشتباه را بکنه، اثرش خیلی جدی تره. اینجا دیگر سوال فقط «دقت مدل چقدره؟» نیست. باید بپرسم خطا برای چه کسی اتفاق می افته، چه کسی می تونه اعتراض کنه و آیا انسان فرصت بررسی دوباره داره یا نه. به نظرم این بخش از یاد گرفتن AI جدا نیست، چون مدل بیرون از دنیای واقعی استفاده نمی شه.
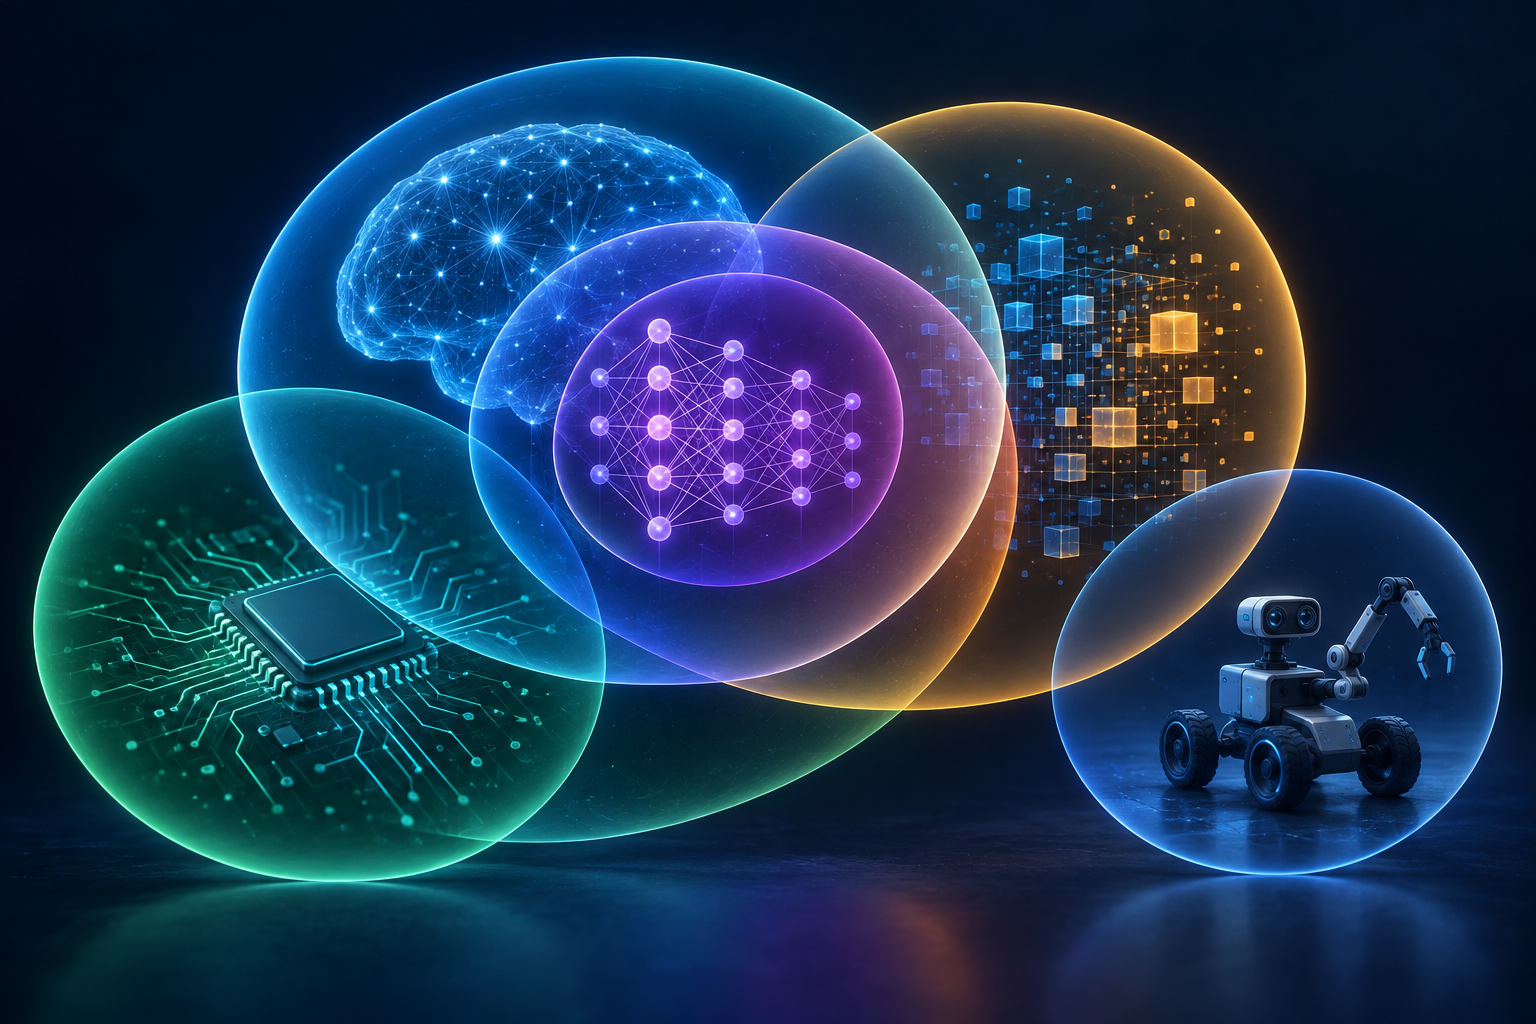
AI، ماشین لرنینگ و بقیه فامیل ها
یکی از چیزهایی که دوست داشتم در همین جلسه اول مرتب کنم، رابطه AI با یادگیری ماشین، یادگیری عمیق، علم داده و رباتیک بود.
یادگیری ماشین معمولا زیرمجموعه AI حساب می شه. ایده اش اینه که سیستم با داده و تجربه، در یک کار مشخص بهتر بشه. مثلا مدلی که از نمونه های ایمیل یاد می گیره کدام پیام ها احتمالا اسپم هستن، یک نمونه ساده از این ماجراست.
در یادگیری نظارت شده، داده های آموزشی جواب درست هم دارن. مثلا برای هر ایمیل می دونیم اسپم بوده یا نبوده. مدل رابطه بین ویژگی های ورودی و آن برچسب را یاد می گیره و بعد باید روی ایمیلی که قبلا ندیده حدس بزنه. راهنمای گوگل هم روی همین بخش آخر تاکید می کنه: مدل را باید با داده ندیده سنجید، وگرنه ممکنه فقط مثال های تمرینی را خوب بلد باشه.
در یادگیری بدون نظارت، معمولا برچسب آماده نداریم و می خواهیم الگو یا گروه پیدا کنیم. مثلا می شه آهنگ ها را بر اساس ویژگی های صوتی در گروه های مشابه گذاشت، بدون این که از اول اسم هر گروه را به مدل داده باشیم. این روش جواب هر مسئله ای نیست، ولی به من یادآوری می کنه که «یادگیری» همیشه به معنی داشتن پاسخ نامه کامل نیست.
هر دو روش به داده خوب وابسته ان. داده زیاد اگر نامرتبط، ناقص یا پر از خطا باشه، معجزه نمی کنه. داده آموزشی باید تا جای ممکن شبیه شرایطی باشه که مدل بعدا در آن استفاده می شه. اگر مدل را فقط با عکس های روشن و تمیز آموزش بدم، نباید ازش انتظار داشته باشم در شب بارانی همان قدر مطمئن کار کنه. این نکته ساده به نظر می رسه، ولی خیلی از شکست های واقعی از همین فاصله بین داده تمرین و دنیای استفاده میاد.
یادگیری عمیق هم زیرمجموعه ای از یادگیری ماشینه. واژه عمیق اینجا به پیچیدگی و تعداد لایه های مدل اشاره داره، نه این که مدل رفته باشه یک گوشه عمیق فکر کرده باشه. مدل های شبکه عصبی چند لایه معمولا در این دسته قرار می گیرن.
یک شبکه عصبی عمیق معمولا چند لایه میانی داره. لایه های ابتدایی ممکنه الگوهای ساده تر را بگیرن و لایه های بعدی ترکیب پیچیده تری از آن ها بسازن. برای تصویر می شه خیلی ساده تصور کرد که لایه های اول لبه و بافت را می بینن و لایه های بعدی از کنار هم گذاشتن آن ها به شکل های پیچیده تر می رسن. این فقط یک تصویر ذهنیه، نه توضیح کامل همه معماری ها. مهم برای من اینه که «عمیق» نام یک روش جادویی نیست، به ساختار مدل اشاره داره.
مدل عمیق همیشه انتخاب بهتر نیست. مدل های ساده تر گاهی با داده کمتر، هزینه پایین تر و توضیح پذیری بیشتر کار می کنن. اگر یک مدل ساده همان نیاز را پوشش می ده، دلیل خوبی ندارم که فقط برای اسم خفن تر سراغ مدل بزرگ تر برم. پیچیدگی باید جواب مسئله باشه، نه دکور پروژه.
علم داده هم با AI همپوشانی داره، ولی یکی نیستن. در علم داده ممکنه تمرکز روی جمع آوری، تمیز کردن، تحلیل و تصویرسازی داده باشه. بعضی وقت ها برای این کار از یادگیری ماشین استفاده می شه و بعضی وقت ها هم نه.
برای من علم داده بیشتر شبیه کارآگاهیه که اول باید بفهمه سوال درست چیه. قبل از انتخاب مدل، باید ببینم داده از کجا اومده، چه خانه هایی خالی ان، واحدها با هم جور در میان یا نه و آیا اصلا داده می تونه به سوال جواب بده. ممکنه بعد از این بررسی بفهمم یک نمودار ساده یا یک قانون شفاف از یک مدل پیچیده مفیدتره. این نتیجه شکست نیست. اتفاقا یعنی ابزار را به خاطر مسئله انتخاب کردم، نه برعکس.
رباتیک هم فقط ربات های انسان نما نیست. یک ربات معمولا حسگر داره تا محیط را بسنجه و عملگر داره تا در محیط کاری انجام بده. بازوی صنعتی، پهپاد و بعضی وسیله های نقلیه خودکار می تونن در این دسته باشن. چت بات را گاهی ربات صدا می زنن، ولی از نظر رباتیک فیزیکی، آن داستان جداست.
رباتیک جاییه که خیلی از شاخه ها مجبور می شن با هم همکاری کنن. حسگر داده می ده، بینایی ماشین ممکنه آن داده را تفسیر کنه، برنامه ریزی مسیر انتخاب می کنه و عملگر حرکت را انجام می ده. اگر یک بخش اشتباه کنه، بقیه بخش ها هم اثرش را می بینن. به همین دلیل، ساختن یک ربات قابل اعتماد فقط مسئله داشتن یک مدل خوب نیست. سخت افزار، تاخیر، ایمنی، کنترل و شرایط محیط هم به همان اندازه وارد بازی می شن.
نقشه این حوزه ها را هم نباید مثل یک درخت خانوادگی خیلی خشک ببینم. دوره می گه یادگیری ماشین معمولا زیر AI قرار می گیره، ولی با آمار هم همپوشانی داره. علم داده هم در بخش هایی با برنامه نویسی، آمار و یادگیری ماشین گره می خوره. پس اگر دو نمودار متفاوت دیدم که جای دایره ها کمی فرق داره، لازم نیست یکی را خراب حساب کنم. مهم اینه بفهمم هر کدوم روی چه مسئله ای تمرکز دارن.
آزمون تورینگ و اتاق چینی
بعد از بحث های فنی، دوره یک پیچ جالب به سمت فلسفه می زنه. سوال اصلی اینه: اگر یک ماشین طوری رفتار کنه که ما نتونیم از آدم تشخیصش بدیم، آیا واقعا باهوشه؟
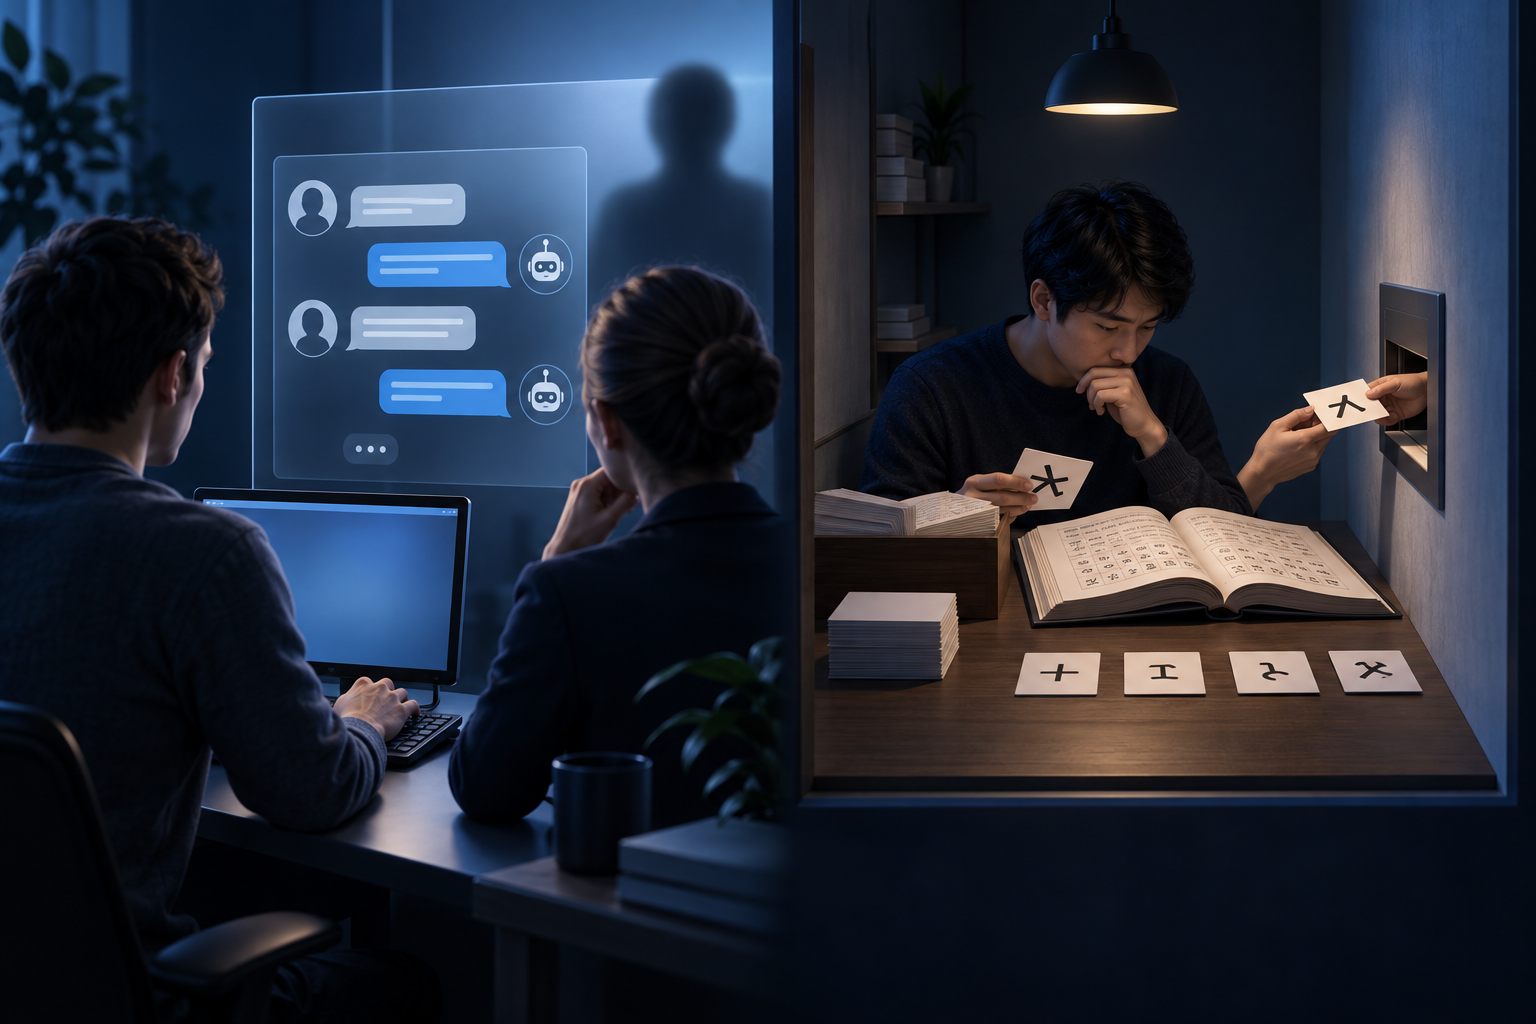
آزمون تورینگ از همین سوال میاد. در شکل اصلی این آزمون، یک داور با دو طرف از راه متن گفتگو می کنه. یکی انسان و یکی ماشین. اگر داور نتونه تشخیص بده کدام طرف ماشینه، می گن ماشین آزمون را رد کرده.
آلن تورینگ این ایده را در مقاله Computing Machinery and Intelligence در سال ۱۹۵۰ مطرح کرد. به جای این که مستقیم بپرسه «آیا ماشین فکر می کند؟»، بازی تقلید را پیشنهاد داد. گفتگو متنیه تا ظاهر، صدا یا بدن طرف ها در قضاوت دخالت نکنه. این حرکت هوشمندانه بود، چون یک سوال مبهم را به موقعیتی قابل مشاهده تبدیل می کرد.
با این حال آزمون تورینگ یک برگه گواهی همیشگی برای هوش نیست. نتیجه اش به نوع سوال، زمان گفتگو، انتظار داور و طراحی آزمون بستگی داره. یک سیستم ممکنه در گفتگوی کوتاه طبیعی به نظر بیاد ولی در دنبال کردن یک مسئله بلند، بررسی واقعیت یا روبه رو شدن با موقعیت تازه ضعیف عمل کنه. از آن طرف، یک سیستم می تونه در کار مهمی مثل پیش بینی ساختار مولکولی خیلی مفید باشه ولی اصلا برای گفتگوی انسانی ساخته نشده باشه. پس آزمون بیشتر یک لنز برای فکر کردن به رفتار هوشمندانه است تا خط پایان همه بحث ها.
این آزمون خیلی جذابه، چون به جای این که بپرسه داخل ماشین چه خبر داره می پرسه بیرون چه رفتاری می بینیم. ولی ایرادش هم همینه. یک سیستم ممکنه خیلی خوب تقلید کنه، جواب های مبهم بده یا بحث را عوض کنه و برای چند دقیقه آدم را گول بزنه. آیا این یعنی فهم عمیق داره؟ جواب قطعی نداریم.
اتاق چینی جان سرل دقیقا به همین تردید حمله می کنه. تصور کن کسی داخل یک اتاقه و زبان چینی بلد نیست. از بیرون برگه هایی با نشانه ها وارد اتاق می شن و او با کمک یک کتاب راهنما، برگه پاسخ درست را پیدا می کنه و برمی گردونه. آدم بیرون شاید فکر کنه داخل اتاق کسی چینی بلده، ولی فرد داخل فقط دستورها را دنبال کرده.
سرل این آزمایش ذهنی را در مقاله Minds, Brains, and Programs در سال ۱۹۸۰ مطرح کرد. حرف اصلی اش این نبود که کامپیوترها هیچ کار مفیدی نمی تونن بکنن. اعتراضش به ادعای قوی تری بود: این که اجرای برنامه به تنهایی برای داشتن فهم یا ذهن کافی باشه. او تفاوت بین دستکاری نشانه ها بر اساس قواعد و داشتن معنا را پررنگ می کرد.
این استدلال جواب های جدی هم گرفته. معروف ترینشان «پاسخ سیستم»ه. می گه شاید فرد داخل اتاق چینی بلد نباشه، ولی کل سیستم شامل فرد، کتاب دستور، حافظه و قواعد پاسخ، چینی را بفهمه. در این جواب، اشتباه اینه که ویژگی یک بخش را به کل سیستم نسبت بدیم. پاسخ های دیگری هم می گن اگر سیستم با دوربین، حسگر و عملگر به جهان وصل بشه، داستان فرق می کنه. Stanford Encyclopedia of Philosophy این نقدها، از جمله پاسخ سیستم و پاسخ ربات را با جزئیات مرور می کنه.
من قرار نیست اینجا برنده بحث را اعلام کنم، چون هنوز هم اختلاف واقعی وجود داره. چیزی که از اتاق چینی یاد می گیرم اینه که خروجی درست، پاسخ روان و حتی تقلید خوب از آدم، به تنهایی جواب همه سوال های مربوط به فهم، معنا و آگاهی نیستن. این احتیاط جلوی دو واکنش افراطی را می گیره: نه بگم هر پاسخ خوب حتما نشانه ذهنه، نه بگم چون تعریف نهایی فهم را نداریم پس همه کاربردهای AI بی ارزش هستن.
برای من، اتاق چینی قرار نیست ثابت کنه همه سیستم های AI بی معنی هستن. بیشتر کمک می کنه بین تولید پاسخ درست و فهمیدن آن پاسخ فرق بذارم. این فرق، مخصوصا وقتی با مدل های زبانی حرف می زنیم، ارزش فکر کردن داره.
هوش باریک و رویای هوش عمومی
تقریبا همه سیستم های AI که امروز واقعا استفاده می کنیم، هوش باریک دارن. یعنی برای یک یا چند کار مشخص ساخته شدن. مدل تشخیص تصویر، سیستم پیشنهاد موسیقی یا ابزار ترجمه ممکنه در کار خودش عالی باشه، ولی نمی تونه بدون طراحی تازه بره رانندگی کنه یا مالیات من را حساب کنه.
هوش باریک به معنی بی اهمیت بودن نیست. یک سیستم باریک ممکنه در کار خودش از آدم سریع تر، دقیق تر یا ارزان تر باشه. مسئله اینه که توانایی اش را بی دلیل به کارهای دیگر تعمیم ندم. مدلی که متن را خوب خلاصه می کنه، لزوما منبع را درست بررسی نمی کنه. سیستمی که در یک مجموعه داده دقت بالا داره، لزوما در شهر، زبان یا گروه دیگری همان نتیجه را نمی ده. اسم درست توانایی، کمک می کنه انتظار درست هم داشته باشم.
هوش عمومی یا AGI، ایده سیستمیه که بتونه دامنه بزرگی از کارهای فکری را مثل انسان انجام بده. این همون چیزیه که معمولا در داستان های علمی تخیلی پررنگه. ولی نباید آن را با ابزارهای واقعی امروز قاطی کنم.
«ضعیف» و «قوی» هم یک جفت اصطلاح نزدیک ولی متفاوتن. در زبان فلسفی، AI ضعیف به سامانه ای اشاره می کنه که رفتار هوشمندانه نشان می ده، بدون این که لازم باشه برایش ذهن یا آگاهی فرض کنم. AI قوی ادعای بزرگ تری داره: این که خود سیستم واقعا ذهن و فهم داره. این تقسیم بندی با باریک و عمومی یکی نیست. یک سیستم می تونه در عمل باریک باشه و بحث فلسفی درباره فهمیدنش همچنان باز بمونه.
برای استفاده روزمره، به نظرم بهتره به جای چسبیدن به برچسب عمومی یا هوشمند، فهرست توانایی ها و محدودیت ها را بخونم. ورودی سیستم چیه؟ خروجی اش چیه؟ چه چیزهایی را خوب انجام می ده؟ کجاها خطا می کنه؟ آیا نتیجه اش قابل بررسیه؟ NIST در چارچوب مدیریت ریسک AI، ویژگی هایی مثل اعتبار و قابلیت اطمینان، ایمنی، امنیت، شفافیت، توضیح پذیری، حریم خصوصی و مدیریت سوگیری را کنار هم می ذاره. این فهرست یادم می ندازه «کار می کنه» برای یک سیستم مهم، توضیح کاملی نیست.
جلسه اول برای من با یک جواب کوتاه تموم نمی شه. AI یک برچسب ساده برای یک چیز واحد نیست. بیشتر یک نقشه شلوغه که باید آرام آرام یاد بگیرم هر بخشش کجاست. فعلا هم اگر جایی دیدم یک ابزار همه کاره معرفی شده، اول دنبال دسته سیم های پشت صحنه می گردم.
منابع و ادامه راه
این پست بر اساس سه بخش اول فصل اول دوره Elements of AI نوشته شده:
- چرا تعریف AI سخت است؟
- حوزه های نزدیک مثل یادگیری ماشین، علم داده و رباتیک
- آزمون تورینگ، اتاق چینی و هوش باریک
- پیشنهاد اصلی پروژه Dartmouth برای AI
- آرشیو مقاله آزمون تورینگ
- چارچوب مدیریت ریسک AI از NIST
- تعریف به روز OECD از سیستم AI
- راهنما و واژه نامه یادگیری ماشین گوگل
- مرور نقدها و پاسخ های اتاق چینی در Stanford Encyclopedia of Philosophy
جلسه بعدی می رم سراغ حل مسئله با AI. احتمالا آنجا تازه می فهمم چرا یک مسئله ساده روی کاغذ، وقتی می رسه به کامپیوتر، گاهی مثل جوراب گمشده توی ماشین لباسشویی ناپدید می شه.